
Trong thế giới dữ liệu rộng lớn ngày nay, khả năng hiểu và phân tích thông tin là một kỹ năng vô cùng giá trị. Đặc biệt, khi làm việc với các tập dữ liệu lớn, việc tổ chức chúng thành các nhóm là phổ biến. Bài viết này từ Đồ Thờ Lăng Vân sẽ đi sâu vào cách tìm tứ phân vị của mẫu số liệu ghép nhóm, một phương pháp thống kê mạnh mẽ giúp bạn nắm bắt được sự phân bố và các điểm mốc quan trọng trong dữ liệu của mình.
Tứ phân vị là gì và vì sao cần xác định chúng?
Tứ phân vị là các giá trị chia một tập dữ liệu đã sắp xếp thành bốn phần bằng nhau, mỗi phần chứa khoảng 25% số lượng quan sát. Chúng bao gồm ba điểm chính:
- Tứ phân vị thứ nhất (Q1): Giá trị mà 25% dữ liệu nhỏ hơn hoặc bằng nó.
- Tứ phân vị thứ hai (Q2): Giá trị giữa của tập dữ liệu, còn được gọi là trung vị, nơi 50% dữ liệu nhỏ hơn hoặc bằng nó.
- Tứ phân vị thứ ba (Q3): Giá trị mà 75% dữ liệu nhỏ hơn hoặc bằng nó.
Việc xác định tứ phân vị mang lại cái nhìn sâu sắc về phân bố dữ liệu, giúp chúng ta hiểu rõ hơn về xu hướng tập trung và mức độ phân tán của các giá trị. Khác với các chỉ số như số trung bình, tứ phân vị ít bị ảnh hưởng bởi các giá trị ngoại lai (outliers), từ đó cung cấp một bức tranh đáng tin cậy hơn về bản chất của dữ liệu. Đối với mẫu số liệu ghép nhóm, việc tìm tứ phân vị đòi hỏi một phương pháp tính toán đặc thù, vì chúng ta chỉ có tần số của các khoảng giá trị chứ không phải từng giá trị cụ thể.
Chuẩn bị dữ liệu để tính tứ phân vị ghép nhóm
Trước khi đi sâu vào các công thức và bước tính toán, việc chuẩn bị dữ liệu là vô cùng quan trọng để đảm bảo kết quả chính xác khi tìm tứ phân vị của mẫu số liệu ghép nhóm. Đầu tiên, bạn cần đảm bảo rằng dữ liệu đã được tổ chức dưới dạng bảng tần số ghép nhóm. Mỗi nhóm (lớp) sẽ có một khoảng giá trị (ví dụ: [150; 155)) và tần số tương ứng (số lượng phần tử trong nhóm đó).
Một bước không thể thiếu là tính tần số tích lũy cho từng nhóm. Tần số tích lũy của một nhóm là tổng tần số của nhóm đó và tất cả các nhóm đứng trước nó. Giá trị cuối cùng của tần số tích lũy sẽ chính là tổng cỡ mẫu (n) của toàn bộ dữ liệu. Đây là yếu tố then chốt để xác định nhóm chứa tứ phân vị cần tìm. Đôi khi, dữ liệu ban đầu có thể ở dạng rời rạc (ví dụ: số lần gặp sự cố là số nguyên). Trong trường hợp này, bạn cần hiệu chỉnh các khoảng nhóm để chúng trở thành các khoảng liên tục, ví dụ từ [1; 2] thành [0.5; 2.5). Việc này giúp cho việc áp dụng các công thức tính toán được chính xác hơn.
Phương pháp và công thức xác định tứ phân vị
Việc xác định tứ phân vị trong mẫu số liệu ghép nhóm tuân theo một quy trình cụ thể, bắt đầu bằng việc tìm vị trí của tứ phân vị và sau đó áp dụng công thức tương ứng. Hiểu rõ từng thành phần trong công thức là chìa khóa để thực hiện tính toán một cách chính xác.
<>Xem Thêm Bài Viết:<>- Giải Đáp Chi Tiết 2004 Thuộc Mệnh Gì Theo Phong Thủy
- Tử Vi Bắc Phái PDF: Cẩm Nang Chiêm Nghiệm Vận Mệnh Toàn Diện
- Tử Vi Quý Mão Nam Mạng 2025: Luận Giải Chi Tiết Vận Hạn Năm Ất Tỵ
- Tử Vi Trọn Đời Tuổi: Chiêm Nghiệm Vận Mệnh Từ Lá Số
- Tu Vi Ngày 17/9/2024: Hướng Dẫn Tâm Linh Chiêu Tài Lộc
Xác định vị trí của Q1, Q2, Q3 trong dữ liệu ghép nhóm
Để tìm tứ phân vị của mẫu số liệu ghép nhóm, bước đầu tiên là xác định vị trí tương đối của chúng trong tổng số liệu. Cỡ mẫu (n) là tổng số phần tử trong tập dữ liệu.
- Vị trí của Q1: Là phần tử thứ
(n/4). - Vị trí của Q2 (Trung vị): Là phần tử thứ
(n/2). - Vị trí của Q3: Là phần tử thứ
(3n/4).
Sau khi tìm được vị trí này, chúng ta sẽ dựa vào bảng tần số tích lũy để xác định nhóm (khoảng) chứa tứ phân vị đó. Nhóm chứa tứ phân vị là nhóm đầu tiên mà tần số tích lũy của nó lớn hơn hoặc bằng vị trí của tứ phân vị.
Công thức tổng quát để tính tứ phân vị của mẫu số liệu ghép nhóm
Công thức tổng quát để ước lượng tứ phân vị ($Q_k$) của một mẫu số liệu ghép nhóm là:
$Q_k = L + left( frac{frac{k cdot n}{4} – C}{f} right) cdot h$
Trong đó:
L: Là giới hạn dưới của nhóm chứa tứ phân vị (khoảng bắt đầu của nhóm).n: Là tổng cỡ mẫu.k: Là chỉ số của tứ phân vị (k = 1 cho Q1, k = 2 cho Q2, k = 3 cho Q3).C: Là tần số tích lũy của nhóm ngay trước nhóm chứa tứ phân vị. Nếu nhóm chứa tứ phân vị là nhóm đầu tiên, C = 0.f: Là tần số của nhóm chứa tứ phân vị.h: Là độ dài (chiều rộng) của nhóm chứa tứ phân vị ($h = text{Giới hạn trên} – text{Giới hạn dưới}$).
Công thức này giúp chúng ta nội suy một cách gần đúng giá trị của tứ phân vị trong khoảng mà nó nằm.
Hướng dẫn tính tứ phân vị thứ nhất (Q1)
Để tính tứ phân vị thứ nhất (Q1), chúng ta thực hiện theo các bước sau:
- Xác định vị trí của Q1: Tìm vị trí
(n/4). - Tìm nhóm chứa Q1: Dựa vào bảng tần số tích lũy, xác định nhóm đầu tiên có tần số tích lũy lớn hơn hoặc bằng
(n/4). - Áp dụng công thức: Sử dụng công thức $Q_1 = L + left( frac{frac{1 cdot n}{4} – C}{f} right) cdot h$ với các giá trị
L, C, f, htương ứng của nhóm vừa tìm được.
Ví dụ, nếu có 25 quả bơ với cân nặng như sau:
| Cân nặng (g) | [150; 155) | [155; 160) | [160; 165) | [165; 170) | [170; 175) |
|—|—|—|—|—|—|
| Số quả bơ | 1 | 7 | 12 | 3 | 2 |
| Tần số tích lũy | 1 | 8 | 20 | 23 | 25 |
Tổng cỡ mẫu n = 25. Vị trí Q1 là 25/4 = 6.25. Nhóm chứa Q1 là [155; 160) vì tần số tích lũy của nhóm này (8) lớn hơn 6.25.
Trong nhóm này: L = 155, C = 1 (tần số tích lũy của nhóm trước đó), f = 7, h = 5.
Áp dụng công thức, chúng ta có thể tìm tứ phân vị thứ nhất cho mẫu dữ liệu này.
Hướng dẫn tính trung vị (Q2)
Trung vị (Q2) chính là giá trị nằm giữa của tập dữ liệu và được tính tương tự như Q1 và Q3. Các bước để tính trung vị như sau:
- Xác định vị trí của Q2: Tìm vị trí
(n/2). - Tìm nhóm chứa Q2: Dựa vào bảng tần số tích lũy, xác định nhóm đầu tiên có tần số tích lũy lớn hơn hoặc bằng
(n/2). - Áp dụng công thức: Sử dụng công thức $Q_2 = L + left( frac{frac{2 cdot n}{4} – C}{f} right) cdot h$, hay đơn giản hơn là $Q_2 = L + left( frac{frac{n}{2} – C}{f} right) cdot h$ với các giá trị
L, C, f, htương ứng của nhóm tìm được.
Nếu lấy lại ví dụ cân nặng bơ với n = 25, vị trí Q2 là 25/2 = 12.5. Nhóm chứa Q2 là [160; 165) vì tần số tích lũy của nhóm này (20) lớn hơn 12.5.
Khi đó, L = 160, C = 8, f = 12, h = 5.
$Q_2 = 160 + left( frac{12.5 – 8}{12} right) cdot 5 = 160 + frac{4.5}{12} cdot 5 = 160 + 1.875 = 161.875$.
Giá trị 161.875 g là trung vị, cho thấy một nửa số quả bơ nặng từ 161.875 g trở xuống và một nửa nặng hơn.
Hướng dẫn tính tứ phân vị thứ ba (Q3)
Cuối cùng, để tính tứ phân vị thứ ba (Q3), chúng ta cũng tuân thủ quy trình tương tự:
- Xác định vị trí của Q3: Tìm vị trí
(3n/4). - Tìm nhóm chứa Q3: Dựa vào bảng tần số tích lũy, xác định nhóm đầu tiên có tần số tích lũy lớn hơn hoặc bằng
(3n/4). - Áp dụng công thức: Sử dụng công thức $Q_3 = L + left( frac{frac{3 cdot n}{4} – C}{f} right) cdot h$ với các giá trị
L, C, f, hcủa nhóm tìm được.
Với ví dụ cân nặng bơ (n = 25), vị trí Q3 là (3 * 25) / 4 = 18.75. Nhóm chứa Q3 là [160; 165) vì tần số tích lũy của nhóm này (20) lớn hơn 18.75.
Các giá trị L = 160, C = 8, f = 12, h = 5.
$Q_3 = 160 + left( frac{18.75 – 8}{12} right) cdot 5 = 160 + frac{10.75}{12} cdot 5 = 160 + 4.479 approx 164.479$.
Giá trị này cho biết 75% số quả bơ có cân nặng từ 164.479 g trở xuống.
Ý nghĩa thực tiễn của tứ phân vị trong phân tích dữ liệu
Việc tìm tứ phân vị của mẫu số liệu ghép nhóm không chỉ là một bài toán thuần túy về số học mà còn mang ý nghĩa sâu sắc trong việc phân tích và hiểu rõ dữ liệu thực tế. Ba điểm tứ phân vị Q1, Q2, Q3 chia tập dữ liệu đã sắp xếp thành bốn phần có kích thước bằng nhau, mỗi phần đại diện cho 25% tổng số quan sát. Điều này giúp chúng ta nhanh chóng hình dung được phân bố của dữ liệu, từ đó đưa ra những nhận định chính xác hơn về đặc điểm của tập mẫu.
Một trong những ứng dụng quan trọng là đánh giá độ phân tán của dữ liệu. Khoảng tứ phân vị (Interquartile Range – IQR), được tính bằng Q3 - Q1, là thước đo về độ phân tán của 50% dữ liệu ở giữa. Một IQR nhỏ cho thấy dữ liệu tập trung xung quanh trung vị, trong khi IQR lớn chỉ ra sự phân tán rộng hơn. Ví dụ, trong việc thống kê cân nặng lợn con mới sinh của hai giống A và B, việc ước lượng tứ phân vị giúp các nhà chăn nuôi dễ dàng so sánh và đưa ra quyết định về giống nào có sự phân bố cân nặng tốt hơn hoặc ổn định hơn.
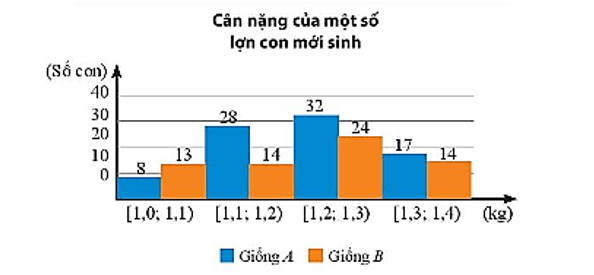 Biểu đồ so sánh cân nặng lợn con giống A và B, minh họa phân bố dữ liệu
Ngoài ra, tứ phân vị còn được dùng để phát hiện các giá trị ngoại lai (outliers) trong dữ liệu, những giá trị nằm quá xa so với phần còn lại của tập hợp. Cụ thể, bất kỳ giá trị nào nhỏ hơn Q1 - 1.5 * IQR hoặc lớn hơn Q3 + 1.5 * IQR đều được coi là ngoại lai tiềm năng. Trong nhiều lĩnh vực như kinh tế, y tế, giáo dục, việc hiểu rõ các chỉ số này là cực kỳ cần thiết để đưa ra các chiến lược, chính sách hoặc dự báo hiệu quả. Từ việc đánh giá chất lượng sản phẩm đến phân tích hiệu suất học tập, khả năng xác định tứ phân vị giúp chúng ta có cái nhìn toàn diện và sâu sắc hơn về mọi khía cạnh của cuộc sống.
Câu hỏi thường gặp khi tìm tứ phân vị của mẫu số liệu ghép nhóm
1. Tứ phân vị và trung vị khác nhau như thế nào?
Trung vị (Q2) là một trong ba tứ phân vị, cụ thể là điểm chia dữ liệu thành hai nửa bằng nhau (50% dữ liệu nhỏ hơn hoặc bằng nó). Tứ phân vị bao gồm ba điểm: Q1, Q2 và Q3, chia dữ liệu thành bốn phần, mỗi phần 25%.
2. Khi nào nên sử dụng tứ phân vị thay vì số trung bình?
Nên sử dụng tứ phân vị khi dữ liệu có sự phân bố không đối xứng hoặc chứa các giá trị ngoại lai. Tứ phân vị ít bị ảnh hưởng bởi những giá trị cực đoan này hơn so với số trung bình, mang lại cái nhìn đáng tin cậy hơn về xu hướng trung tâm của phần lớn dữ liệu.
3. Làm thế nào để xử lý dữ liệu ghép nhóm có khoảng không liên tục (ví dụ: [1-5], [6-10])?
Trước khi áp dụng công thức, bạn cần hiệu chỉnh các khoảng này để chúng trở thành liên tục. Ví dụ, [1-5] và [6-10] sẽ được hiệu chỉnh thành [0.5; 5.5) và [5.5; 10.5). Việc hiệu chỉnh này đảm bảo tính chính xác khi tính tứ phân vị.
4. Ý nghĩa của khoảng tứ phân vị (IQR) là gì?
Khoảng tứ phân vị (IQR = Q3 – Q1) đo lường độ phân tán của 50% dữ liệu nằm ở giữa. Nó là một chỉ số mạnh mẽ về độ phân tán, ít nhạy cảm với các giá trị ngoại lai so với khoảng biến thiên toàn bộ (Max – Min). IQR càng nhỏ, dữ liệu càng tập trung.
Hiểu rõ cách tìm tứ phân vị của mẫu số liệu ghép nhóm là một công cụ mạnh mẽ giúp bạn phân tích dữ liệu một cách chuyên sâu, từ đó đưa ra những đánh giá chính xác và hữu ích. Dù trong lĩnh vực học thuật hay ứng dụng thực tế, khả năng này sẽ mở ra nhiều góc nhìn mới mẻ và giá trị. Đồ Thờ Lăng Vân hy vọng bài viết này đã cung cấp cho bạn những kiến thức cần thiết để tự tin khám phá thế giới dữ liệu phức tạp.